13 第十三章 残差向量量化 (RVQ)
上一章我们探讨了VQ-VAE。它通过单层码本将连续潜变量离散化,但在实际应用中(尤其是在高保真音频生成与压缩领域如SoundStream),单层VQ很快会遇到瓶颈。本章将介绍残差向量量化(Residual Vector Quantization,RVQ)网络用于解决单层码本效果不佳的问题。
13.1 单码本量化的瓶颈
单码本量化,假设码本包含 \(K\) 个向量,每个向量维度为 \(D\)。每一个时间步或空间位置上的潜向量 \(z_e \in \mathbb{R}^D\) 都会被替换为与其距离最近的单一码字 \(e_k\)。
这带来了一个核心矛盾:码本容量与计算复杂度之间的权衡。
若码本大小 \(K = 1024 = 2^{10}\),则每个位置只能提供 10 比特(bits)的信息量。想要提升量化精度、减少量化失真,就需要大幅提升\(K\)。
如果将比特率提高到 80 比特,单码本需要的条目数将是 \(K = 2^{80}\)。在工程上无论存储这样大小的码本或计算 \(\arg\min\) 都是无法接受的。此外,当 \(K\) 很大时,极易发生码本坍塌,即只有少数热门码字被频繁激活,大部分码字从未被使用。
为了在不增加单次计算 \(\arg\min\) 的前提下大幅提高潜空间的表达精度,RVQ应运而生。
13.2 RVQ 的核心机制
RVQ 的思想十分朴素:利用多个层级的较小码本,逐级对前一级的量化残差进行级联量化。
它不再追求单个码本一次性达到很高的精度,而是采用先定轮廓,再补细节的逐层渐进逼近策略。
假设我们级联了 \(N\) 个量化器 \(Q_1, Q_2, \dots, Q_{N}\),每个量化器各自维护一个独立的码本 \(E_m \in \mathbb{R}^{D \times K}\)。
给定编码器输出的潜变量 \(z_e\):
第 1 级量化: 将初始潜向量作为第 0 阶残差 \(r_0 = z_e\),在第1个量化器 \(Q_1\) 中寻找与 \(r_0\) 最近的码字: \[ z_q^{(1)} = Q_1(r_0) = \arg\min_{e \in E_1} \|r_0 - e\|_2 \tag{13.1}\] 随后计算第 1 级的量化误差,即残差: \[ r_1 = r_0 - z_q^{(1)} \tag{13.2}\]
第 2 级量化: 第 2 个量化器不再去量化原始的 \(z_e\),而是专门量化第一级遗留下的残差 \(r_1\): \[ z_q^{(2)} = Q_2(r_1) = \arg\min_{e \in E_2} \|r_1 - e\|_2 \tag{13.3}\] 产生新的残差: \[ r_2 = r_1 - z_q^{(2)} \tag{13.4}\]
第 \(m\) 级量化: 以此类推,对于任意第 \(m\) 级(\(1 \le m \le N\)): \[ z_q^{(m)} = Q_m(r_{m-1}) \tag{13.5}\] \[ r_m = r_{m-1} - z_q^{(m)} \tag{13.6}\]
这个过程如 图 13.1 所示:
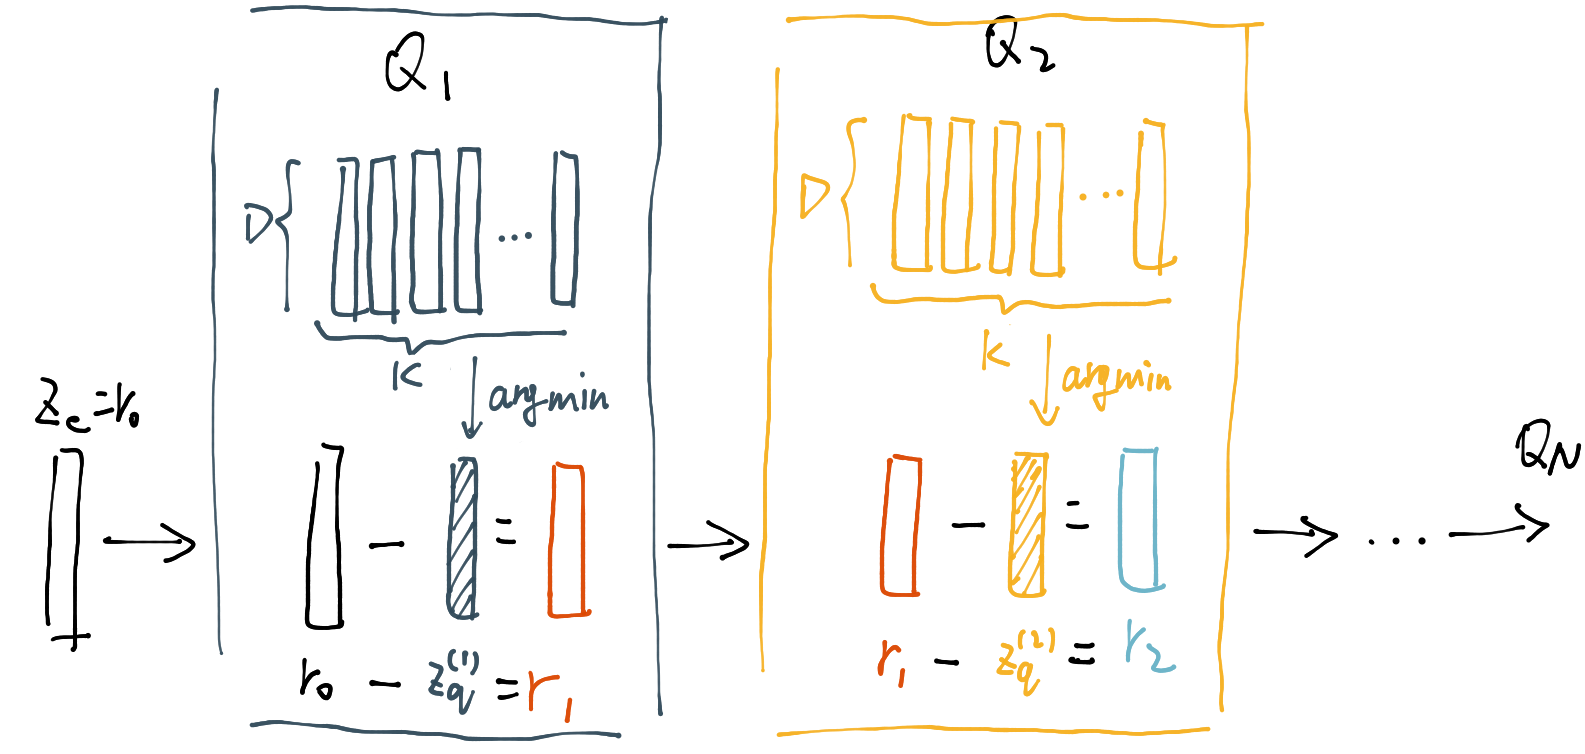
当经过全部 \(N\) 级残差量化后,送入解码器的最终量化潜向量 \(\hat{z}\) 等于所有层级选出的量化码字之和: \[ \hat{z} = \sum_{m=1}^{N} z_q^{(m)} \tag{13.7}\]
最终的逼近误差为最后一级的残差: \[ r_{N} = z_e - \hat{z} \tag{13.8}\]
随着级数 \(N\) 的增加,\(r_{N}\) 迅速衰减,量化表征精度呈指数级提升。
13.3 参数量与容量的对比
对比单码本与 RVQ 的容量增长曲线:
单码本:若每个码本包含 \(K\) 个码字,信息容量为 \(\log_2(K)\) 比特,参数量为 \(D \times K\)。
RVQ:拥有 \(N\) 个大小为 \(D \times K\) 的码本,参数量仅为线性的 \(N \times K \times D\),但它能组合出的有效离散状态数却达到了: \[ K^{N} \] 对应的信息容量高达 \(N \log_2(K)\) 比特。
例如,采用 \(N = 8\) 个大小为 \(K = 1024\)(10 比特)的128通道码本:
码本大小为 $8 $,能够表达的组合数高达 \(1024^8 \approx 1.2 \times 10^{24}\)(80 比特),解决了大码本计算开销问题,还让训练变得更加稳定。
13.4 损失函数与反向传播
与普通 VQ-VAE 一样,RVQ 中每级量化操作同样包含不可微的 \(\arg\min\) 操作。我们需要将直通估计器(STE)推广到多级级联结构中。
在前向传播中,最终送入解码器的量化结果为 \(\hat{z} = \sum_{m=1}^{N} z_q^{(m)}\)。为了让解码器的梯度能够直接流回编码器,计算梯度时应用 STE: \[ \hat{z}_{\text{out}} = z_e + \text{sg}[\hat{z} - z_e] \tag{13.9}\]
这样在反向传播时,\(\nabla_{z_e} \mathcal{L} \approx \nabla_{\hat{z}_{\text{out}}} \mathcal{L}\),解码器的梯度被完整无损地直接传回编码器输出 \(z_e\)。
对于各个层级的码本与残差,每一级都需要对应的约束来协同优化:
承诺损失:约束前一级的残差 \(r_{m-1}\) 不偏离当前级选中的码字 \(z_q^{(m)}\)。
码本损失:促使第 \(m\) 级码本向残差 \(r_{m-1}\) 靠拢(和VQ-VAE一样)。
全模型的总损失函数写为: \[ \mathcal{L} = \mathcal{L}_{\text{recon}}(x, \hat{x}) + \sum_{m=1}^{N} \left( \beta \|r_{m-1} - \text{sg}[z_q^{(m)}]\|_2^2 + \|\text{sg}[r_{m-1}] - z_q^{(m)}\|_2^2 \right) \tag{13.10}\]
其中 \(\beta\) 通常取 0.25。
13.5 量化器丢弃
在训练 RVQ 时,还有一个至关重要的技巧:量化器丢弃。
在标准 RVQ 中,如果每一次前向传播都把所有 \(N\) 级码本加满,模型可能会产生依赖,低层码本可能会“偷懒”,寄希望于高层码本去修补缺陷。
为了解决这个问题并在推理时获得可变比特率的能力,在训练时会随机截断使用的码本层数:
每次前向传播时,从集合 \(\{1, 2, \dots, N\}\) 中随机采样一个整数 \(M\)。
仅计算前 \(M\) 级量化结果进行相加求和: \[ \hat{z} = \sum_{m=1}^{M} z_q^{(m)} \tag{13.11}\]
丢弃第 \(M+1\) 到 \(N\) 级。
这样做带来了两个显著优势:
逼迫前几级量化器必须全力去捕捉最核心的能量与全局语义结构(粗粒度信息),而后续层级则专注于填补微小的局部纹理与高频细节(细粒度信息)。
训练完成后,单个模型可以在推理阶段根据算力或网络带宽随时调节层数 \(M\)。例如网络畅通时使用 8 级码本获得广播级音质,网络较差时降级到 2 级码本传输,依然能保持基本语音清晰可辨。
RVQ 在现代神经音频编解码与生成式大模型中扮演着类似“文本分词器”的角色。Google 的 SoundStream 和 Meta 的 EnCodec 均使用 RVQ 作为核心潜空间表示。它们将 24kHz 或 48kHz 的高采样率音频压缩至仅几百赫兹的潜表征帧率,并利用多级 RVQ 将其转化为离散的 token 矩阵。